こんにちは、フロントエンドのR.Tです。
この記事では、最近情報収集系のBotを二つ制作しました。
そこでの知見を載せようと考え、筆を執った次第です。
社内で利用する情報収集Botとして、AI関連のアップデートを収集するBotと、セキュリティ関連情報を収集するBotの2種類をGoogle Apps Script(GAS)で構築しました。
外部サイトの更新を取得して社内チャットへ通知するだけであれば、それほど複雑な仕組みは必要ありません。
しかし実際に運用すると、すぐに問題にぶつかります。
通知を増やせば情報は拾いやすくなる一方、通知が多すぎると誰も見なくなる。
逆に通知を減らそうとしてフィルタを厳しくすると、本当に必要な情報まで落としてしまう。
今回の開発では、このトレードオフをどう扱うかが大きなテーマになりました。
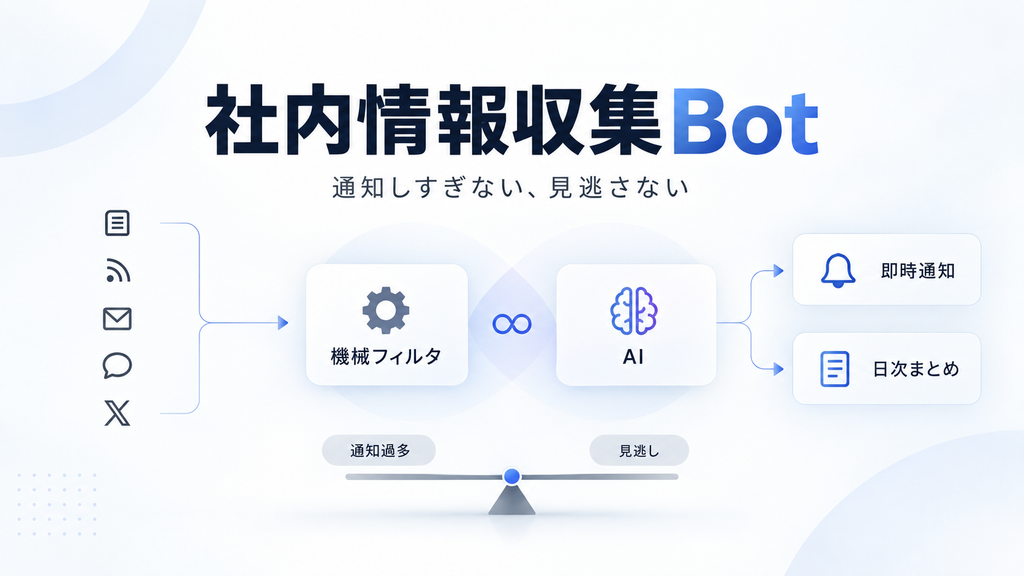
単純にフィルタの条件を増やすのではなく、機械的なルール判定とAIによる意味判定、それぞれの得意分野を分けることで、通知量を抑えながら取りこぼしも減らす構成を目指しました。
作ったもの
システム全体は、大きく以下のような流れになっています。
外部の公開情報

    ↓

定期取得

    ↓

新着・重複判定

    ↓

機械フィルタ

    ↓

AIフィルタ

    ↓

重要度を分類

    ↓

即時通知 / 日次まとめ(Webページ)
実行基盤にはGAS、データ保存にはGoogleスプレッドシートを利用しています。
重要度の高い情報だけを社内チャットへ即時通知し、それ以外は日次まとめやWebページから確認できる構成です。
ここで重要なのは、「通知しない情報」と「不要な情報」を同じものとして扱っていない点です。
すぐ見る必要がないだけで、有用な情報である可能性はあります。そのため、即時通知から外れた情報も基本的には日次まとめ側へ残します。
これによって、即時通知側の条件をある程度厳しくしても、情報そのものを失わない構成にしました。
通知量と取りこぼしは単純なフィルタでは両立しにくい
従来のキーワードや条件式による機械フィルタは、高速で外部APIの利用料も発生せず、同じ入力には同じ結果を返してくれるという大きなメリットがあります。
一方で、条件を厳しくすると取りこぼしが増え、条件を緩くすると通知量が増えるという問題があります。
例えば、「重要そうな単語が含まれているものだけを通す」とすれば通知量は減らせます。
しかし、重要な更新が常に想定した単語で表現されるとは限りません。
逆に候補となる単語を増やし続ければ取りこぼしは減りますが、今度は無関係な情報まで大量に通るようになります。
つまり、一つの機械フィルタだけで精度を上げようとすると、「通知過多」と「取りこぼし」の間を行き来しやすいということです。
そこで今回、この二つを同じフィルタで解決しようとするのをやめました。
機械フィルタの受け口を広げ、AIに曖昧な判断を任せる
今回の構成では、機械フィルタを完全な判定器として使うのではなく、AIへ渡す前段として利用しています。
役割は大きく分けると次のようになります。
| 機械フィルタ | AIフィルタ | |
|---|---|---|
| 得意なこと | 明確な条件判定 | 文脈・意味の判断 |
| 特徴 | 高速・外部API費用なし・決定論的 | 柔軟・従量課金・確率的 |
| 今回の役割 | 明らかなものを整理する | 曖昧な候補を判断する |
ポイントは、機械フィルタを以前より少し広めに設定したことです。
以前は、特定条件に一致した情報だけを次の判定へ進める構成でした。
この方式はAIの利用量を抑えるには有効ですが、実際のデータを確認すると、AIが判断する前の段階で候補を落としすぎていました。
許可リストにどれだけキーワードを追加しても、未知の表現を完全に網羅することはできません。
そこで、機械フィルタを「通す・落とすための門」ではなく、明らかに判断できるものを整理しつつ、曖昧なものを広めにAIへ渡す層へ変更しました。
これによって、機械側で無理に精度を出そうとする必要がなくなります。
そのうえでAIには、「この情報を今すぐ通知する価値があるか」といった、ルールだけでは判断しづらい部分を担当させます。
結果として、次のような中間の構成になりました。
・すべてAIへ渡す
→ 精度は出しやすいが、処理件数に比例してAPI費用が発生する

・すべて機械判定する
→ 外部API費用はかからないが、条件が複雑化しやすく取りこぼしも残る


機械で明確なものを処理 + 曖昧な候補だけAIで判断
→ API利用量を抑えながら意味判定も利用できるAIを使うことで機械フィルタをなくすのではなく、機械フィルタを少し雑にできるようになった、という表現のほうが今回の設計には近いと思います。
AIのコストは小さい。それでも使う場所は絞る
今回利用しているAIモデルは比較的低コストで、実測でも1件の判定にかかる費用は数銭程度に収まっています。
そのため、AI利用料そのものがシステム運用の大きな負担になるわけではありません。
ただし、処理件数に比例して費用が発生することには変わりません。また、AIは外部サービスへの通信が必要で、機械判定と比べれば処理時間も長くなります。
そこで、単純な条件式だけで確実に判断できるものまでAIへ送ることはしていません。
機械で判断できる

→ 機械で処理する

機械だけでは判断しづらい

→ AIへ渡す
という役割分担にしています。
この構成によって、API利用量を必要な範囲に限定しながら、機械フィルタだけでは難しかった意味的な判定を利用できます。
今回の設計では、AIを極力使わないことが目的なのではなく、AIを使う価値がある場所にだけ使うことを重視しました。
「検知」と「通知」を分けて考える
もう一つ重要だったのが、情報を見つけることと、チャットへ通知することを分けて考えたことです。
収集した情報をすべて即時通知すれば、取りこぼしはほぼなくせます。
しかし、それでは通知が多くなり、本当に重要な情報まで他の通知に埋もれてしまいます。
一方で、通知数を減らすために取得段階で情報そのものを削除すると、後から確認することもできません。
広く検知する
↓
重要なものだけ即時通知する
↓
残りは日次まとめへ残す
という構造にしました。
この構成なら、情報収集側ではある程度広く拾いつつ、社員がリアルタイムで受け取る通知だけを絞ることができます。
今回のBotでは、フィルタの目的を「不要な情報を削除すること」ではなく、情報の届け方を決めることとして設計しています。
重複排除は強ければよいわけではなかった
実際の運用では、フィルタ以外にもいくつか問題が発生しました。その一つが重複排除です。
当初は二重通知を防ぐため、タイトルやURLなど複数の情報を使って比較的強く重複判定を行っていました。
ところが、同じ見出しを繰り返し使用する情報源では、別の更新まで同じ情報として扱われるケースが発生しました。
逆にタイトルを識別子へ強く含めると、提供元が説明文を少し修正しただけで別の記事と判定され、過去情報が再通知されることもあります。
最終的には、情報源の性質によって「何をもって同じ情報とするか」を変えるようにしました。
この経験から、重複排除も単なる前処理ではなく、取りこぼしと二重通知のトレードオフを持つ処理だと分かりました。
動いているように見える故障も検知する
情報収集Botで厄介なのは、完全に停止する故障だけではありません。
取得元の構造変更などによって、「10件取れていたものが2件だけになる」といった部分的な故障もあります。
処理自体は成功しているため、単純にエラーの有無だけを見ていると正常に見えてしまいます。
そこで、次のような状態も確認するようにしました。
- 取得件数が通常より極端に少ない
- 必要な項目が取得できていない
- 監視処理そのものが一定期間正常完了していない
また、通常の情報通知とは別に、Bot自身の異常を知らせる経路も用意しています。
日次まとめについても、単なるニュース一覧ではなく、毎日正常に動作しているかを確認するための生存確認として利用しています。
「通知がない」のか「監視自体が止まっている」のかを区別できる状態にすることも、情報収集システムでは重要でした。
AIは精度向上だけでなく、ルールを単純に保つためにも使える
AI導入というと、「AIに全部判断させる」構成を想像しやすいかもしれません。
今回のシステムでは逆で、AIを追加することで、機械フィルタ側にすべての判断ロジックを詰め込まなくて済むようになりました。
従来のルールだけで精度を上げようとすると、次のような条件が増え続けます。
この単語なら対象

ただしこの組み合わせなら除外

ただしこの製品名なら対象

この表現の場合だけ例外
条件が増えるほど、修正による影響範囲も見えにくくなります。
そこで、明確な判断だけをルールとして残し、それ以外をAIへ任せるようにしました。
機械判定には外部API利用料がかからないため、最初の振り分けを担わせるには非常に相性が良いです。
そのうえで、意味判断が必要な候補にだけAIを利用すれば、すべてをAIへ送るよりAPI利用量を抑えられます。
つまり今回AIを導入した目的は単純な精度向上だけではなく、コストのかからない機械判定と、柔軟な意味判断ができるAIを組み合わせることで、コストと精度の両方を改善することでもありました。
AIを段階的に本番へ入れる
AIを組み込んだ後も、すぐに判定結果を本番通知へ反映したわけではありません。
まずAIへ渡る候補数を確認し、その後AIにも実際に判定させ、既存ルールとの違いを記録しました。
そのうえで、結果を確認してから通知判定へ反映しています。
ルール判定

↓

AI対象候補を記録

↓

AIにも判定させる
ただし通知には反映しない

↓

ルールとの差分を確認

↓

本番判定へ反映
これによって、APIの利用量や判定傾向を本番投入前に確認できます。
特に従量課金のサービスでは、「おそらくこの程度だろう」と想定するだけではなく、実際に何件がAIへ渡り、どの程度の費用になるのかを測ってから本番へ入れることが重要です。
また、問題が発生した場合にはAIを停止し、機械判定だけへ戻せる構成を維持しています。
AIへ渡す入力も信用しない
今回扱っているのは外部サイトから取得した文章なので、AIへ渡す文字列も信頼できる入力とは考えていません。
そのため、AIへ渡す情報を必要最小限に絞り、入力サイズにも上限を設けています。
また、システム側で保持している情報と、外部から取得した文字列を明確に分けています。
AIの出力についても、そのまま通知へ使用するのではなく、期待している形式かを検証したうえで利用します。
想定した形式から外れた場合やAIサービスを利用できない場合には、機械フィルタ側の判定へ戻します。
AIをシステム全体の単一障害点にしないことも、今回の設計で重視した点です。
実行環境の制約も設計に影響した
GASには実行時間などの制約があります。
そのため、すべての情報源を処理した後に結果をまとめて確定するのではなく、処理が完了した単位から順次確定する方式にしました。
一つの外部取得処理が停止した場合でも、それ以前に正常処理できた情報まで巻き込まないためです。
データ整理についても、古いデータを1件ずつ処理する方法ではデータ量の増加とともに処理時間が伸びたため、データの持ち方自体を変更しました。
このあたりは、コード単体の高速化よりも、実行環境に合わせて処理単位や保存方法を設計することのほうが重要でした。
まとめ
今回の開発で最も難しかったのは、「情報を取得すること」そのものではありませんでした。
通知を増やしすぎれば誰も見なくなる。
しかし、通知を減らすためにフィルタを強くすれば必要な情報まで落ちる。
というトレードオフをどう扱うかでした。
今回、この問題に対して一つの完璧なフィルタを作るのではなく、次のように役割を分割しました。
- 外部API費用のかからない機械フィルタで明確な判断をする
- 受け口は必要以上に狭くしない
- 曖昧な部分だけをAIで判断する
- 即時通知しない情報も日次まとめへ残す
AIにすべて任せるわけでもなく、従来のルールベースだけに固執するわけでもありません。
コストをかけず安定して動く機械判定と、少額のコストで柔軟な意味判断ができるAIを組み合わせ、それぞれの弱点を補う。
結果として、AIは単なる追加機能ではなく、機械フィルタを必要以上に複雑にせず、APIコストを抑えながら通知精度と取りこぼし防止を両立するための一つのレイヤーになりました。
実際に運用してみると、AIモデルそのものの性能だけでなく、その前後にある取得、フィルタ、重複排除、フォールバック、監視、復旧設計まで含めて初めて、継続して使える情報収集Botになると感じています。
ここまでご覧いただきありがとうございました。